
Los falsos positivos son el impuesto oculto de un programa de KYT. Cada alerta que salta sobre una transacción inocua cuesta tiempo de análisis, ralentiza a usuarios legítimos y erosiona la credibilidad del propio control. Cuando un equipo se pasa el día cerrando alertas que nunca debieron abrirse, las alertas que importan reciben menos atención. Reducir ese ruido es un problema de configuración de reglas, no de herramientas. Esta guía trata por qué las reglas de KYT disparan de más, en qué se diferencia la configuración de reglas de la revisión posterior a la alerta, y las prácticas de ajuste, puntuación, prueba y medición que devuelven la precisión. Para la superficie completa de KYT, consulta Phalcon Compliance. Esta página pertenece al Centro de recursos de KYT.
Por qué las reglas de KYT producen falsos positivos
Una regla de KYT es una condición de disparo: cuando una dirección o una transacción cruza un umbral de riesgo definido, la regla lanza una alerta. El problema de los falsos positivos es estructural a ese diseño. Una regla puesta para atrapar a toda contraparte de riesgo marca también toda dirección que alguna vez tocó indirectamente un servicio de riesgo, que en una economía de cadenas interconectadas es un conjunto enorme. Cuanto más amplio el disparador, más actividad legítima arrastra. Los informes del sector describen de forma consistente los falsos positivos como la carga operativa dominante de la monitorización de transacciones, tanto en servicios financieros como en cripto, con las falsas alertas superando con mucho a los casos confirmados. La cuestión no es fijar una cifra, sino reconocer que disparar de más es la condición de base de la monitorización basada en reglas, no la excepción.
Y esa monitorización no es opcional: bajo el enfoque basado en el riesgo del GAFI para activos virtuales, reforzado en Estados Unidos por la norma de programa AML (31 CFR 1022.210) y la norma de comunicación de actividades sospechosas (31 CFR 1022.320) de FinCEN, la monitorización continua de transacciones es una obligación permanente, así que un equipo no puede resolver los falsos positivos apagando reglas, solo ajustándolas.
Cuatro decisiones de configuración generan casi todo ese ruido. Unos umbrales demasiado bajos marcan todo lo que supere una puntuación de riesgo trivial, tratando una exposición indirecta puntual igual que una interacción directa con una entidad sancionada. Unas condiciones de disparo que ignoran el contexto —importe, frecuencia, dirección, profundidad de la contraparte— funden patrones de riesgo distintos en un mismo flujo. Las reglas que nunca se ajustan tras el despliegue siguen saltando con patrones que el equipo ya ha descartado. Y las reglas que puntúan en caja negra obligan a quien analiza a tratar toda alerta como potencialmente real, porque no puede ver por qué saltó. Cada una es un fallo de configuración, corregible en la capa de reglas antes de que ninguna alerta llegue a una persona.
El coste se acumula. Quien trabaja una cola de falsos positivos desarrolla fatiga por alertas: la tendencia a desconectar de una señal que se equivoca demasiado a menudo. Los verdaderos positivos enterrados en el ruido se cierran entonces con menos escrutinio, porque la expectativa previa de quien analiza es que la alerta probablemente esté mal. Un conjunto de reglas ruidoso no solo hace perder tiempo: baja la calidad de la revisión de las alertas que de verdad importan.
Arregla las reglas aguas arriba, no las alertas aguas abajo
De estas dos capas se habla a menudo como si fueran el mismo problema. No lo son, y confundirlas es lo primero que descarrila un esfuerzo de reducción de falsos positivos. La configuración de reglas es el trabajo de definir, antes de analizar ninguna transacción, qué condiciones producen una alerta. Vive aguas arriba. La revisión posterior a la alerta es lo que hace quien analiza después de que una alerta haya saltado: investigarla, decidir si es un verdadero positivo y resolverla. Vive aguas abajo. La distinción importa porque reducir los falsos positivos en la capa de reglas impide que la alerta llegue a crearse, mientras que reducirlos en la capa de revisión solo vacía más rápido la cola existente. Las dos cosas tienen valor, pero son trabajos distintos hechos por personas distintas: la configuración de reglas la hace quien sea dueño del programa de monitorización, la revisión posterior la hace quien trabaja la cola.
Una prueba útil para saber a qué capa pertenece un problema: si el mismo tipo de alerta salta una y otra vez sobre el mismo tipo de actividad inocua, la solución está en la configuración de reglas. Si una alerta concreta cuesta de resolver porque las evidencias son escasas, la solución está en las herramientas de revisión. Lo primero previene el ruido. Lo segundo lo atraviesa más rápido. Esta página cubre solo lo primero.
Ajustar reglas para cortar el ruido
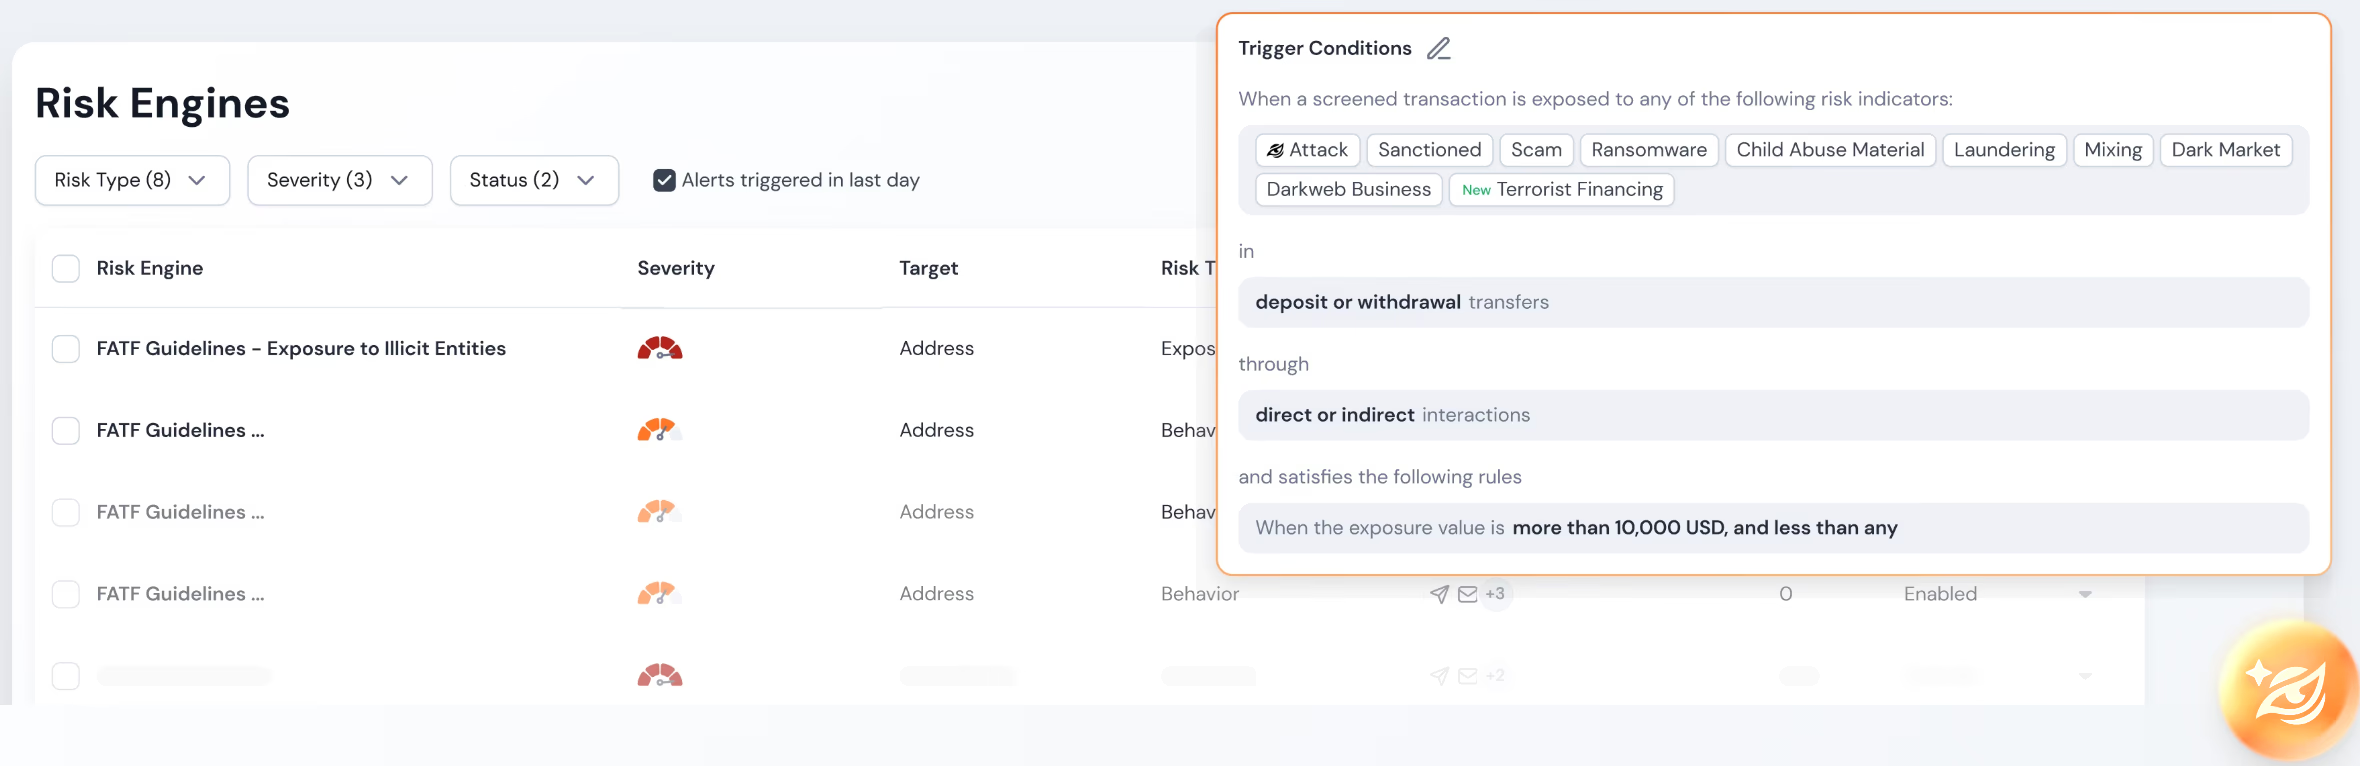
El ajuste de reglas es la palanca más directa para reducir falsos positivos, y actúa sobre las cuatro decisiones de configuración que provocan los disparos de más. El ajuste de umbrales es el primer movimiento. Una regla que salta con cualquier puntuación de riesgo por encima de cero disparará de más. Llevar el umbral a una banda que refleje exposición real —y emparejarlo con una banda de retención por debajo del umbral de bloqueo, para que los casos límite vayan a revisión manual— recorta el volumen de alertas de señal baja. Phalcon Compliance lo expone a través de su motor de riesgo configurable, que viene con cinco plantillas preconstruidas y un conjunto de reglas por defecto construido en torno al enfoque basado en el riesgo del GAFI, y permite ajustar umbrales, disparadores y enrutado de notificaciones regla a regla en lugar de imponer un único ajuste global.
El ajuste de las condiciones de disparo es el segundo movimiento. Una regla que salta solo por el riesgo de la contraparte ignora si la exposición fue un contacto indirecto puntual o una interacción directa repetida. Añadir contexto —importe mínimo, frecuencia de repetición, dirección de los fondos, profundidad de la exposición a contrapartes— separa los patrones que indican riesgo real de los que son normales en una economía de cadenas donde las direcciones tocan muchas contrapartes. El motor de riesgo configurable permite superponer estas condiciones regla a regla, así que un equipo puede empezar amplio e ir estrechando a medida que aprende qué filtros separan los verdaderos positivos del ruido.
El tercer movimiento es la cadencia de ajuste. Las reglas se degradan. Un umbral fijado en el primer trimestre puede estar equivocado en el tercero porque el comportamiento de las contrapartes se desplaza y la mezcla de direcciones cambia. Los equipos que mantienen a raya los falsos positivos revisan su conjunto de reglas con una cadencia fija —mensual o trimestral— usando como base de evidencias las alertas ya resueltas. Si una regla produjo ochenta alertas el mes pasado y setenta y cinco eran falsos positivos, es candidata a ajuste. Ajustar no es una configuración de una sola vez: es una práctica recurrente.
El cuarto movimiento es el enrutado de notificaciones. La plataforma admite notificación multicanal, webhook incluido, para que las reglas enruten por severidad en lugar de volcar todas las alertas en una misma cola. La severidad alta va a un canal inmediato, la media a una cola de revisión, la baja a un registro. Enrutar por severidad significa que la cola que llega a quien analiza viene prefiltrada con las alertas que merecen atención humana.
La puntuación explicable reduce los falsos positivos
El mayor amplificador de falsos positivos es una puntuación de riesgo que devuelve un número sin explicación. Cuando una regla salta con una puntuación opaca, quien analiza no puede saber si saltó por una exposición directa a una entidad sancionada, por una exposición indirecta a través de un mezclador o por un patrón de comportamiento que parece estratificación. Hay que tratar toda alerta como potencialmente real, porque no hay ninguna señal con la que descartarla. El resultado es una cola donde todo se revisa con la misma profundidad: la definición de precisión baja.
La puntuación explicable rompe ese patrón. Phalcon Compliance devuelve una puntuación de riesgo de caja transparente construida sobre más de 600 millones de direcciones etiquetadas y 17 categorías de indicadores de riesgo. La puntuación llega con los indicadores que la motivaron y las cifras de exposición que hay detrás, así que cuando una regla salta, quien analiza puede ver por qué. Si saltó por una única exposición indirecta a una contraparte, sin indicadores de comportamiento, se puede cerrar rápido y con confianza. Si saltó por un montón de indicadores de comportamiento más una exposición directa a un servicio ilícito conocido, recibe todo el escrutinio. Los indicadores no solo aceleran la revisión: permiten ajustar la propia regla con más precisión, porque el equipo puede ver qué indicadores correlacionan con los verdaderos positivos y fijar los disparadores en consecuencia.
Esta es la diferencia entre un conjunto de reglas que gana precisión con el tiempo y otro que se queda ruidoso. Con una puntuación opaca, el ajuste es adivinar: el equipo mueve un umbral y confía en que la precisión haya mejorado. Con puntuación explicable, el ajuste se basa en evidencias: el equipo puede ver qué indicadores están produciendo los falsos positivos y ajustar el disparador para ponderarlos de otro modo, o descartarlos. Las 17 categorías de indicadores de riesgo no son solo una superficie de detección: son la base de evidencias que hace ajustable el conjunto de reglas.
Probar los cambios de regla antes de ponerlos en producción
Un cambio de regla que reduce falsos positivos pero introduce falsos negativos no ha mejorado el programa: ha movido el modo de fallo. La forma de evitar ese canje es probar los cambios contra datos históricos antes de ponerlos en producción, para que el equipo vea qué habría atrapado y qué se habría perdido la configuración nueva.
La prueba retrospectiva es la práctica de base. El equipo toma una ventana de alertas históricas —típicamente de tres a seis meses— ya resueltas y las reproduce contra la configuración propuesta. La salida es una comparación: cuántas alertas producía la configuración antigua, cuántas produciría la nueva, y si alguna de las que atrapaba la antigua se habría perdido. Un cambio que recorta el volumen de alertas a la mitad pero deja caer tres verdaderos positivos es una regresión, no una victoria, y la prueba retrospectiva lo detecta antes de producción.
El despliegue en gris es la segunda práctica, para equipos que no pueden hacer una prueba retrospectiva completa o que quieren validar contra tráfico en vivo. La configuración nueva corre en paralelo a la antigua, lanzando alertas a una cola en sombra que nadie revisa, mientras la antigua alimenta la cola en vivo. Pasado un periodo definido, el equipo compara los dos flujos: ¿atrapó la nueva lo que atrapaba la antigua, atrapó algo que esta se perdía, y silenció los falsos positivos que debía silenciar? Solo cuando la comparación se sostiene pasa la configuración nueva a producción. Como el motor de riesgo se configura regla a regla, una comparación en sombra se puede montar sin un entorno separado.
La disciplina de la prueba importa sobre todo cuando un cambio de regla viene motivado por un incidente. Un equipo que acaba de perderse una tipología correrá a ampliar un disparador para atrapar el próximo caso, que es justo el movimiento que produce una oleada de falsos positivos. Probar el disparador ampliado contra datos históricos antes de ponerlo en producción detecta la sobrecorrección pronto, cuando aún sale barato arreglarla.
Medir la eficacia a lo largo del tiempo
Un esfuerzo de reducción de falsos positivos que no se mide no se sostiene. El volumen de alertas baja una semana después de una pasada de ajuste, vuelve a subir al trimestre siguiente, y el equipo no se entera hasta que la cola está otra vez ruidosa. La medición es lo que convierte una limpieza puntual en una ganancia de precisión duradera.
Tres métricas concentran casi toda la señal. La precisión es la proporción de alertas que son verdaderos positivos, y es la medida de cabecera de la tasa de falsos positivos: una precisión del diez por ciento significa que nueve de cada diez alertas son ruido. La exhaustividad es la proporción de actividad realmente arriesgada que las reglas llegan a atrapar, y es el guardarraíl frente a una pasada de ajuste que redujo los falsos positivos dejando escapar verdaderos positivos. Si sube la precisión y baja la exhaustividad, el conjunto de reglas está disparando de menos, no mejorando. El tiempo hasta la resolución —cuánto espera una alerta antes de que alguien la cierre— sigue la eficiencia de la revisión e, indirectamente, si la puntuación explicable está haciendo su trabajo: cuando los indicadores son visibles, el tiempo de resolución baja.
La cadencia de medición debería coincidir con la de ajuste. Cada mes o cada trimestre, el equipo revisa precisión, exhaustividad y tiempo de resolución contra el periodo anterior, identifica las reglas cuya precisión ha caído y las prioriza para la siguiente pasada. Ese es el ciclo: configurar, desplegar, medir, ajustar, repetir. Un conjunto de reglas de KYT es un control que hay que mantener igual que se mantiene el resto del programa de cumplimiento: con un calendario y con evidencias.
Los equipos que tienen éxito reduciendo falsos positivos tratan la configuración de reglas como una práctica continua y no como una tarea de puesta en marcha. Ajustan con una cadencia, puntúan con explicación en lugar de con opacidad, prueban antes de publicar y miden precisión y exhaustividad juntas, para que la reducción de ruido nunca salga a costa de la detección. El resultado es un conjunto de reglas que salta menos veces y pega más fuerte cuando lo hace. Para ver cómo encajan en esa práctica el motor de riesgo configurable y los indicadores de riesgo de caja transparente de Phalcon Compliance, lee la visión general de cumplimiento KYT.