
Fehlalarme sind die versteckte Belastung eines KYT-Programms. Jeder Alarm zu einer unbedenklichen Transaktion kostet Analystenzeit, bremst legitime Nutzer und schwächt die Glaubwürdigkeit der Kontrolle selbst. Verbringt ein Team den Tag mit dem Schließen unnötiger Alarme, erhalten die wichtigen Fälle weniger Aufmerksamkeit. Weniger Rauschen ist eine Frage der Regelkonfiguration, nicht der Tools. Dieser Leitfaden erklärt, warum KYT-Regeln zu oft auslösen, wie sich Konfiguration von nachgelagerter Alarmprüfung unterscheidet und welche Optimierungs-, Scoring-, Test- und Messverfahren die Präzision verbessern. Die gesamten KYT-Funktionen beschreibt Phalcon Compliance. Diese Seite ist Teil des KYT-Wissensportals.
Warum KYT-Regeln Fehlalarme erzeugen
Eine KYT-Regel ist eine Auslösebedingung: Überschreitet eine Adresse oder Transaktion eine definierte Risikoschwelle, entsteht ein Alarm. Das Fehlalarmproblem ist in diesem Aufbau angelegt. Eine Regel für jede riskante Gegenpartei markiert auch jede Adresse, die jemals indirekt einen riskanten Dienst berührt hat – eine sehr große Menge in einer vernetzten Blockchain-Ökonomie. Je breiter der Auslöser, desto mehr legitime Aktivitäten erfasst er mit. Branchenberichte beschreiben Fehlalarme übereinstimmend als wichtigste operative Belastung der Transaktionsüberwachung in Finanzdienstleistungen und Krypto. Falsche Alarme übersteigen bestätigte Fälle bei Weitem. Es geht nicht um eine bestimmte Zahl, sondern darum, dass übermäßiges Auslösen der Normalzustand regelbasierter Überwachung ist, nicht die Ausnahme.
Die Überwachung ist nicht optional. Der risikobasierte Ansatz der FATF für virtuelle Vermögenswerte, in den USA bekräftigt durch FinCENs Vorschrift zu AML-Programmen (31 CFR 1022.210) und Vorschrift zur Meldung verdächtiger Aktivitäten (31 CFR 1022.320), macht die laufende Transaktionsüberwachung zur fortbestehenden Pflicht. Teams lösen Fehlalarme daher nicht durch Abschalten, sondern nur durch Optimieren der Regeln.
Vier Konfigurationsentscheidungen erzeugen den Großteil des Rauschens. Zu niedrige Schwellen markieren alles oberhalb eines minimalen Scores und behandeln einmalige indirekte Exposition wie direkten Kontakt zu einer sanktionierten Entität. Bedingungen ohne Kontext – Betrag, Häufigkeit, Richtung, Tiefe der Gegenparteiexposition – werfen unterschiedliche Risikomuster zusammen. Nach der Einführung nie angepasste Regeln reagieren weiter auf bereits entkräftete Muster. Black-Box-Scoring zwingt Analysten, jeden Alarm als möglicherweise echt zu behandeln, weil der Auslöser verborgen bleibt. Jeder dieser Fehler lässt sich auf Regelebene beheben, bevor ein Alarm einen Menschen erreicht.
Die Kosten summieren sich. Wer eine Fehlalarmwarteschlange abarbeitet, entwickelt Alarmmüdigkeit: die Neigung, ein zu oft falsches Signal nicht mehr ernst zu nehmen. Echte Treffer im Rauschen werden dann weniger sorgfältig geschlossen, weil der Analyst bereits einen Fehlalarm erwartet. Ein lautes Regelwerk verschwendet nicht nur Zeit, sondern verschlechtert die Prüfung der wirklich wichtigen Fälle.
Vorgelagerte Regeln korrigieren statt nachgelagerte Alarme beschleunigt prüfen
Beide Ebenen werden oft wie dasselbe Problem behandelt. Das sind sie nicht. Diese Verwechslung lässt Initiativen zur Fehlalarmreduzierung früh scheitern. Regelkonfiguration definiert vor dem Screening, welche Bedingungen einen Alarm erzeugen. Sie liegt vorgelagert. Die nachgelagerte Alarmprüfung untersucht bereits ausgelöste Alarme, bestimmt echte Treffer und trifft Bearbeitungsentscheidungen. Die Unterscheidung zählt: Auf Regelebene wird die Entstehung eines Fehlalarms verhindert; auf Prüfebene wird nur die vorhandene Warteschlange schneller abgearbeitet. Beides ist wertvoll, aber unterschiedliche Arbeit für unterschiedliche Personen: Konfiguration durch die Programmverantwortlichen, Alarmprüfung durch die Analysten der Warteschlange.
Ein einfacher Zuordnungstest: Reagiert derselbe Alarmtyp immer wieder auf dieselbe unbedenkliche Aktivität, liegt die Lösung in der Konfiguration. Ist ein einzelner Alarm wegen schwacher Belege schwer zu entscheiden, liegt sie in den Prüfwerkzeugen. Ersteres verhindert Rauschen, Letzteres bewältigt es schneller. Diese Seite behandelt nur Ersteres.
Regeln zur Rauschreduzierung optimieren
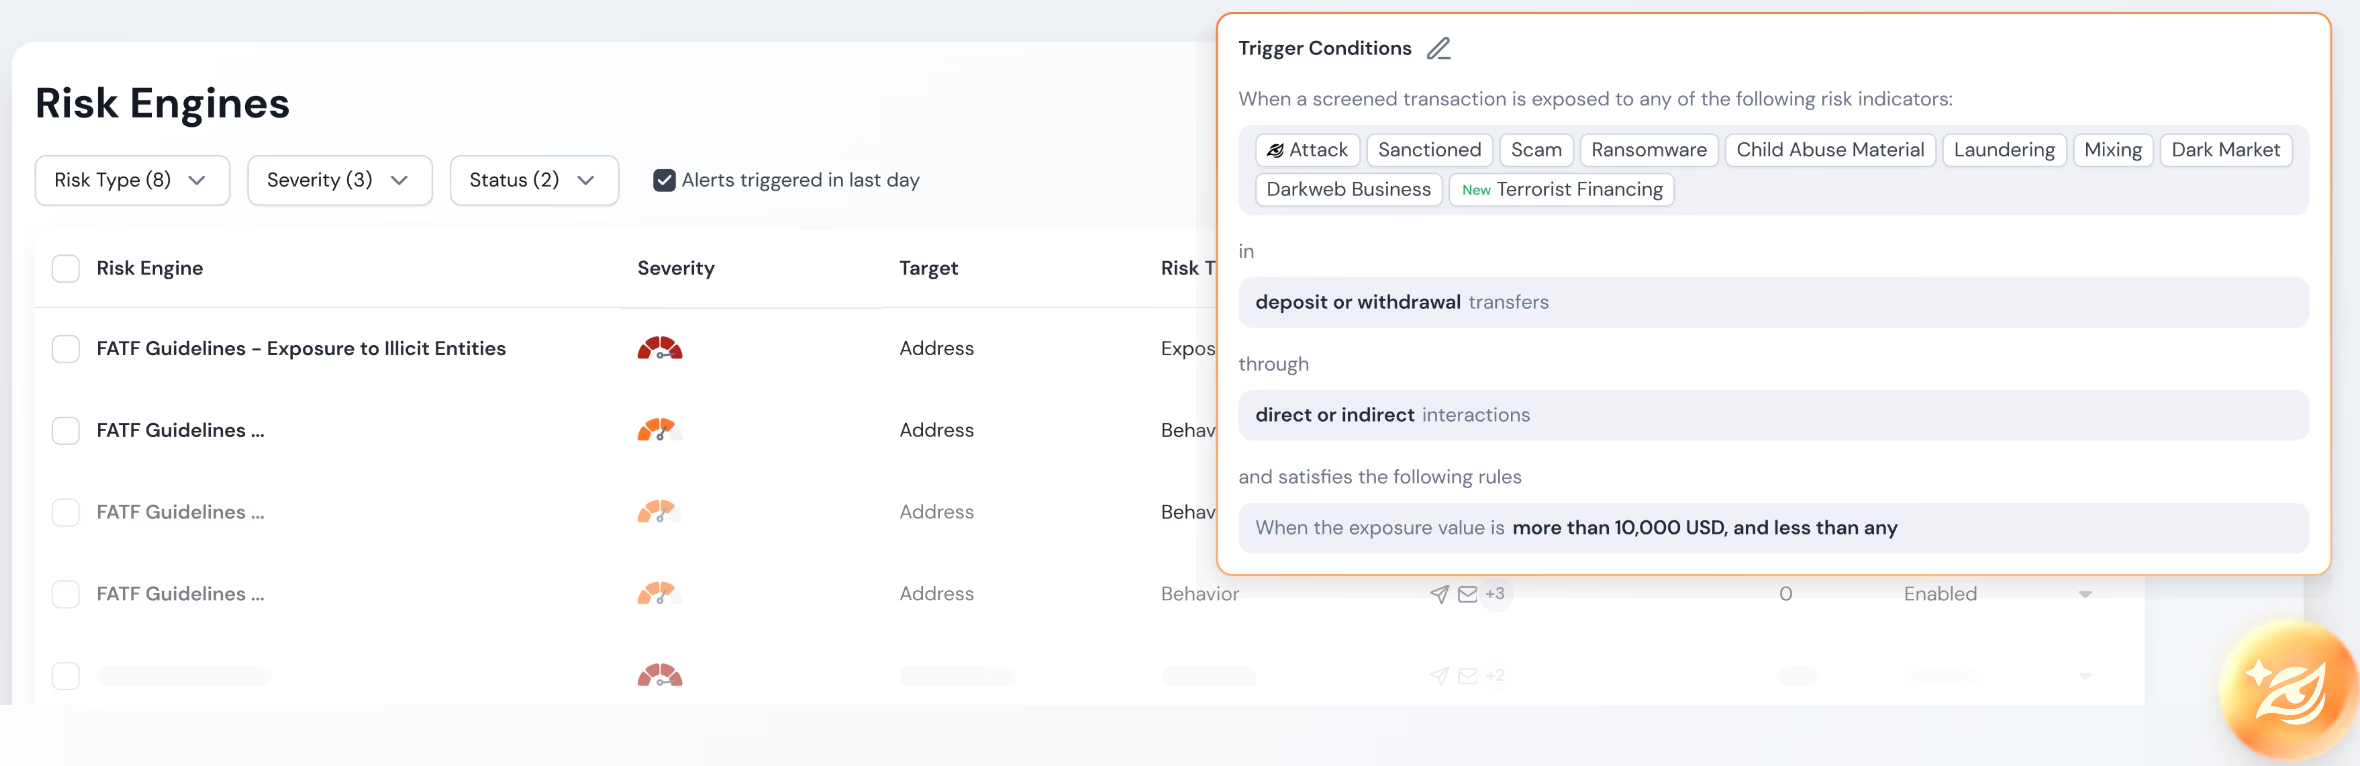
Regeloptimierung ist der direkteste Hebel für weniger Fehlalarme und setzt an den vier Ursachen übermäßiger Auslösungen an. Zuerst werden Schwellen angepasst. Eine Regel für jeden Score oberhalb von null löst zu oft aus. Eine an tatsächlicher Exposition orientierte Schwelle reduziert schwache Alarme. Ein Bereich zum Zurückhalten unterhalb der Blockierschwelle leitet Grenzfälle zur manuellen Prüfung. Phalcon Compliance bietet dafür eine konfigurierbare Risk Engine mit fünf Vorlagen und einem am risikobasierten FATF-Ansatz orientierten Standardregelwerk. Schwellen, Auslöser und Benachrichtigungswege werden je Regel statt nur global angepasst.
Zweitens werden Auslösebedingungen optimiert. Eine Regel allein nach Gegenparteirisiko ignoriert den Unterschied zwischen einmaligem indirektem Kontakt und wiederholter direkter Interaktion. Mindestbetrag, Wiederholungshäufigkeit, Geldflussrichtung und Tiefe der Gegenparteiexposition trennen echte Risikomuster von normalem Verhalten in einer Ökonomie mit vielen Adresskontakten. Die Risk Engine lässt diese Bedingungen pro Regel kombinieren. Teams können breit beginnen und anhand aussagekräftiger Filter schrittweise eingrenzen.
Drittens braucht es einen Optimierungsrhythmus. Regeln verlieren ihre Passgenauigkeit. Eine Schwelle aus dem ersten Quartal kann im dritten falsch sein, weil sich Gegenparteienverhalten und Adressmix verändert haben. Erfolgreiche Teams prüfen monatlich oder vierteljährlich anhand bereits bearbeiteter Alarme. Hat eine Regel letzten Monat achtzig Alarme erzeugt, davon fünfundsiebzig Fehlalarme, sollte sie angepasst werden. Optimierung ist keine einmalige Einrichtung, sondern wiederkehrende Praxis.
Viertens geht es um Benachrichtigungswege. Die Plattform unterstützt mehrere Kanäle einschließlich Webhook, damit Regeln nach Schwere weiterleiten statt alles in eine Warteschlange zu geben. Hohe Schwere führt in einen Sofortkanal, mittlere in eine Prüfwarteschlange, niedrige in ein Protokoll. So erreichen Analysten bereits vorgefiltert die Fälle, die menschliche Aufmerksamkeit verdienen.
Nachvollziehbares Scoring reduziert Fehlalarme
Der größte Verstärker von Fehlalarmen ist ein Risikoscore als Zahl ohne Erklärung. Reagiert eine Regel auf einen undurchsichtigen Score, erkennt der Analyst nicht, ob eine direkte Sanktionsexposition, eine indirekte Mixer-Exposition oder ein verschleierungsähnliches Verhalten dahintersteht. Jeder Alarm muss als möglicherweise echt gelten, weil kein Signal zur Entkräftung vorliegt. Alle Fälle werden gleich tief geprüft – das Gegenteil hoher Präzision.
Nachvollziehbares Scoring durchbricht dieses Muster. Phalcon Compliance liefert einen transparenten Risikoscore auf Grundlage von mehr als 600 Millionen gekennzeichneten Adressen und 17 Risikoindikator-Kategorien. Ausschlaggebende Indikatoren und Expositionswerte werden mitgeliefert. Bei Auslösung sieht der Analyst den Grund. Eine einzelne indirekte Exposition gegenüber einer Gegenpartei ohne Verhaltensindikatoren lässt sich schnell und sicher entkräften. Mehrere Verhaltensindikatoren mit direkter Exposition gegenüber einem bekannten illegalen Dienst erfordern volle Aufmerksamkeit. Die Indikatoren beschleunigen nicht nur die Prüfung. Sie erlauben eine präzisere Regeloptimierung, weil das Team die Korrelation mit echten Treffern erkennt und Auslöser entsprechend setzt.
Das unterscheidet ein mit der Zeit präziseres Regelwerk von einem dauerhaft lauten. Bei undurchsichtigem Scoring wird geraten: Das Team verschiebt eine Schwelle und hofft auf bessere Präzision. Nachvollziehbares Scoring ermöglicht evidenzbasierte Anpassungen: Die Fehlalarme verursachenden Indikatoren werden anders gewichtet oder entfernt. Die 17 Kategorien sind nicht nur Erkennungsfläche, sondern auch die Beleggrundlage für anpassbare Regeln.
Regeländerungen vor dem Produktivstart testen
Eine Änderung mit weniger Fehlalarmen, aber mehr übersehenen Risiken verbessert das Programm nicht. Sie verschiebt nur den Fehler. Testen Sie deshalb vor der Einführung an historischen Daten, was die neue Konfiguration erkannt oder übersehen hätte.
Rücktests bilden die Grundlage. Das Team nimmt einen Zeitraum bereits bearbeiteter historischer Alarme – typischerweise drei bis sechs Monate – und spielt sie gegen die vorgeschlagene Konfiguration erneut ab. Verglichen werden die Alarmzahlen beider Versionen und die vom bisherigen Stand erkannten, künftig aber übersehenen Fälle. Eine Halbierung des Alarmvolumens bei Verlust dreier echter Treffer ist ein Rückschritt. Der Rücktest erkennt ihn vor dem Produktivbetrieb.
Verdeckter Parallelbetrieb ist die zweite Methode für Teams ohne vollständigen Rücktest oder mit zusätzlichem Live-Validierungsbedarf. Die neue Konfiguration läuft neben der alten und schreibt in eine Schattenwarteschlange ohne menschliche Bearbeitung, während die alte die echte Warteschlange versorgt. Nach einem definierten Zeitraum wird verglichen: Erfasst die neue Version bisherige Treffer, zusätzliche übersehene Fälle und unterdrückt sie die vorgesehenen Fehlalarme? Erst bei positivem Vergleich wird sie produktiv. Da die Risk Engine regelweise konfiguriert wird, lässt sich dieser Vergleich ohne separate Umgebung aufbauen.
Die Testdisziplin ist nach Vorfällen besonders wichtig. Wer gerade eine Typologie übersehen hat, erweitert einen Auslöser oft hastig. Genau das erzeugt eine Fehlalarmwelle. Tests an historischen Daten erkennen die Überkorrektur früh, solange sie günstig zu beheben ist.
Wirksamkeit im Zeitverlauf messen
Eine ungemessene Fehlalarmreduzierung hält nicht an. Nach einer Anpassung fällt das Volumen für eine Woche, steigt im nächsten Quartal wieder, und das Team bemerkt es erst an der erneut lauten Warteschlange. Messung macht aus einer einmaligen Bereinigung einen dauerhaften Präzisionsgewinn.
Drei Kennzahlen liefern die wichtigsten Signale. Präzision ist der Anteil echter Treffer an allen Alarmen und das zentrale Maß für die Fehlalarmbelastung. Zehn Prozent Präzision bedeuten, dass neun von zehn Alarmen Störsignale sind. Die Erkennungsquote, auch Recall, ist der Anteil tatsächlich riskanter Aktivitäten, den die Regeln erfassen. Sie schützt davor, Fehlalarme durch übersehene echte Treffer zu reduzieren. Steigt die Präzision bei sinkendem Recall, löst das Regelwerk zu selten aus, statt sich zu verbessern. Die Zeit bis zur Bearbeitungsentscheidung misst, wie lange ein Alarm bis zum Abschluss liegt. Sie zeigt Prüfeffizienz und indirekt den Nutzen nachvollziehbaren Scorings. Sichtbare Indikatoren verkürzen diese Zeit.
Mess- und Optimierungsrhythmus sollten übereinstimmen. Monatlich oder vierteljährlich vergleicht das Team Präzision, Recall und Bearbeitungszeit mit dem Vorzeitraum, erkennt Regeln mit sinkender Präzision und priorisiert sie. Der Kreislauf lautet: konfigurieren, einführen, messen, optimieren, wiederholen. Ein KYT-Regelwerk muss wie das übrige Compliance-Programm planmäßig und anhand von Belegen gepflegt werden.
Erfolgreiche Teams behandeln Konfiguration als laufende Praxis statt als Einrichtungsaufgabe. Sie optimieren regelmäßig, nutzen erklärbares Scoring, testen vor der Einführung und messen Präzision und Recall gemeinsam. So geht weniger Rauschen nie auf Kosten der Erkennung. Das Ergebnis ist ein Regelwerk, das seltener auslöst und dann gezielter trifft. Wie die konfigurierbare Risk Engine und die transparenten Risikoindikatoren von Phalcon Compliance dazu passen, erklärt die KYT-Compliance-Übersicht.